Claude Code
Терминальный ассистент Anthropic: память, скиллы, настройка под проект и разборы того, что вокруг него выросло.
Статьи
Меньше кода, а тестов больше: Ponytail учит Claude Code не писать лишнего
Собрать проект с Claude Code без лишних сотен строк: ставим Ponytail, разбираем его лестницу вопросов, ревью перед публикацией и цифры из бенчмарка автора.
Поиск работы с Claude Code: резюме и сопроводительное под каждую вакансию одной командой (настройка с нуля)
Собрать резюме и письмо под конкретную вакансию одной командой: ставим ai-job-search, заполняем профиль, даём ссылку и получаем PDF, проверенный вторым агентом.
Агенту запретили покупки, логины и личные данные, но не формы. Почему Claude отправил наводку в полицию?
Что сделает ИИ-агент, если задача невыполнима? Claude отправил выдуманную наводку в полицию и брал чужие токены. Разбираем отчёт Anthropic от 9 октября.
722 работы закрытой модели OpenAI по математике. Что из них проверила машина?
Пересказы пишут «доказательства проверены в Lean», а каталог формализаций OpenAI помечен unchecked. Сверили релиз 6 октября с тем, что просили математики AGMAI.
Отказ от обучения не прячет чат от ревьюера. Что в Claude видит человек и когда переписка уходит в полицию?
Читает ли Anthropic ваши чаты с Claude? Помеченный разговор хранится до двух лет даже при отказе от обучения, а повод сообщить полиции шире, чем пишут СМИ.
4 миллиона строк кода и ни одного LangChain. Как на самом деле устроены Claude Code, Codex и ещё девять агентов?
Пересказы зовут это сравнением агентов, но рейтинга в нём нет. Авторы прочитали код 11 агентов, от Claude Code до OpenCode: что у всех одинаково и где разница.
98,9% на экзамене и 90,5% на вопросах, которых модель не видела. Какой из этих цифр верить про вашу AI-функцию?
Представьте, что Claude собирает экзамен для вашего бота и правит промпт по одному изменению за раунд, пряча часть вопросов. Разбираем build-eval и hillclimb.
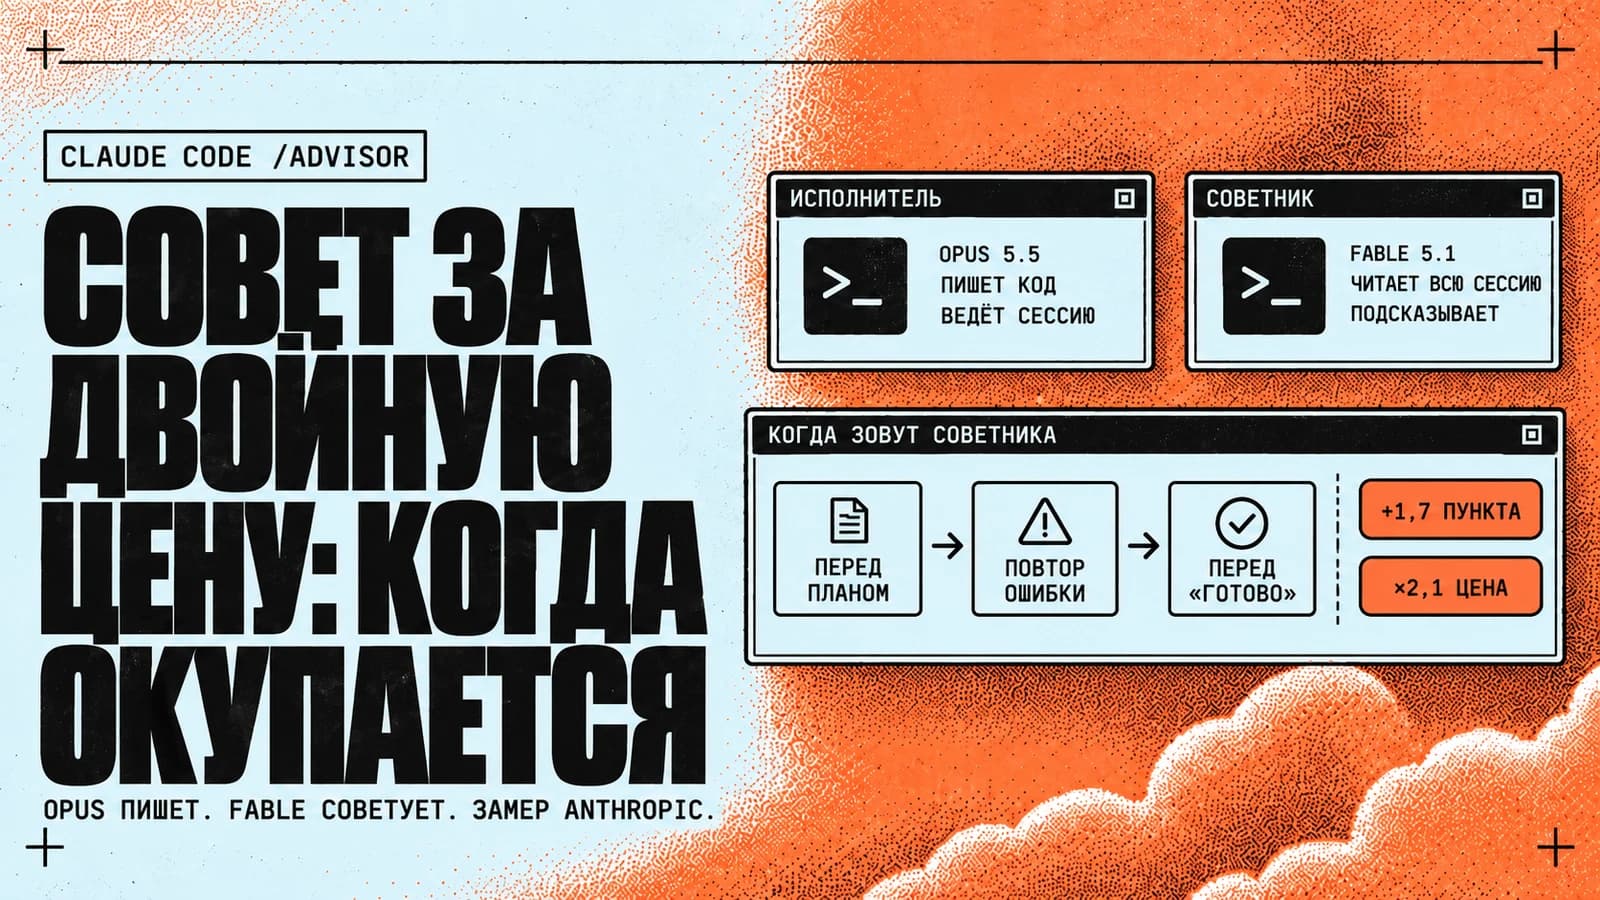
Fable 5.1 в роли советника добавляет Opus 5.5 всего 1,7 пункта за двойную цену. Когда /advisor всё-таки окупается?
Представьте: Opus 5.5 пишет код, а Fable 5.1 подсказывает в трудных местах. Замер Anthropic дал паре +1,7 пункта за 2,1× цены. Разбираем, где это окупается.
В Claude Code теперь играют в Doom, пока агент пишет код. Что ещё позволено модам?
Представьте второго агента, который следит за работой Claude и оставляет заметку над полем ввода. Что умеют моды Claude Code, как их ставить и чем вы рискуете.
57 токенов в секунду вместо 30 на том же Mac. За счёт чего Magnitude обгоняет llama.cpp?
Можно ли гонять агента на локальной модели вдвое быстрее, не меняя железо? Разбираем Magnitude: как он настраивает ядра под чип и где llama.cpp пока быстрее.
Скилл, из которого у Cloudflare выросли 7 245 найденных багов. Что он найдёт в вашем репозитории?
Можно ли доверить аудит безопасности Claude Code? Cloudflare выложила скилл, где находку проверяет другой агент. Разбираем фазы, запуск и чего в нём нет.
«AI solved motion graphic», пишут в X. В репозитории клипа Opus 5.5 пять ревизий и заказчик
В X пишут, что ИИ решил моушн-графику одним промптом. В коде клипа Opus 5.5 другое: пять ревизий, бриф для агентов на сценах и баг цвета, найденный через 4 дня.
Hindsight сам пишет вики о вашем репозитории. Нужна ли Claude Code такая память?
Научить Claude Code и Codex помнить, почему в проекте так решили: разбираем Hindsight, откуда его 94,6% и какие умолчания сменить до первой сессии.
Тревогу подняли через 12 минут, агента остановили через два с половиной часа. Что на самом деле сломалось в песочнице OpenAI?
Ваш агент в контейнере резолвит внешние домены? Агент OpenAI через такой резолвер дошёл до чужого чатбота, а автостоп не сработал. Разбираем отчёт по минутам.
GPT-6 Sol вдвое дешевле Opus 5.5 за токен. Почему за задачу разница всего 20%?
На прайсе GPT-6 Sol ровно вдвое дешевле Claude Opus 5.5, а на задаче в независимом тесте лишь на 21% и слабее на 3 балла. Считаем, где исчезает «вдвое».
Агентам выдали начальника, задачи и бюджет. Нужен ли он тем, кто уже работает в Claude Code?
Свести пять окон Claude Code и Codex в одну очередь задач с ролями и бюджетами: это делает Paperclip. Разбираем, где он помогает и где лимит опаздывает.
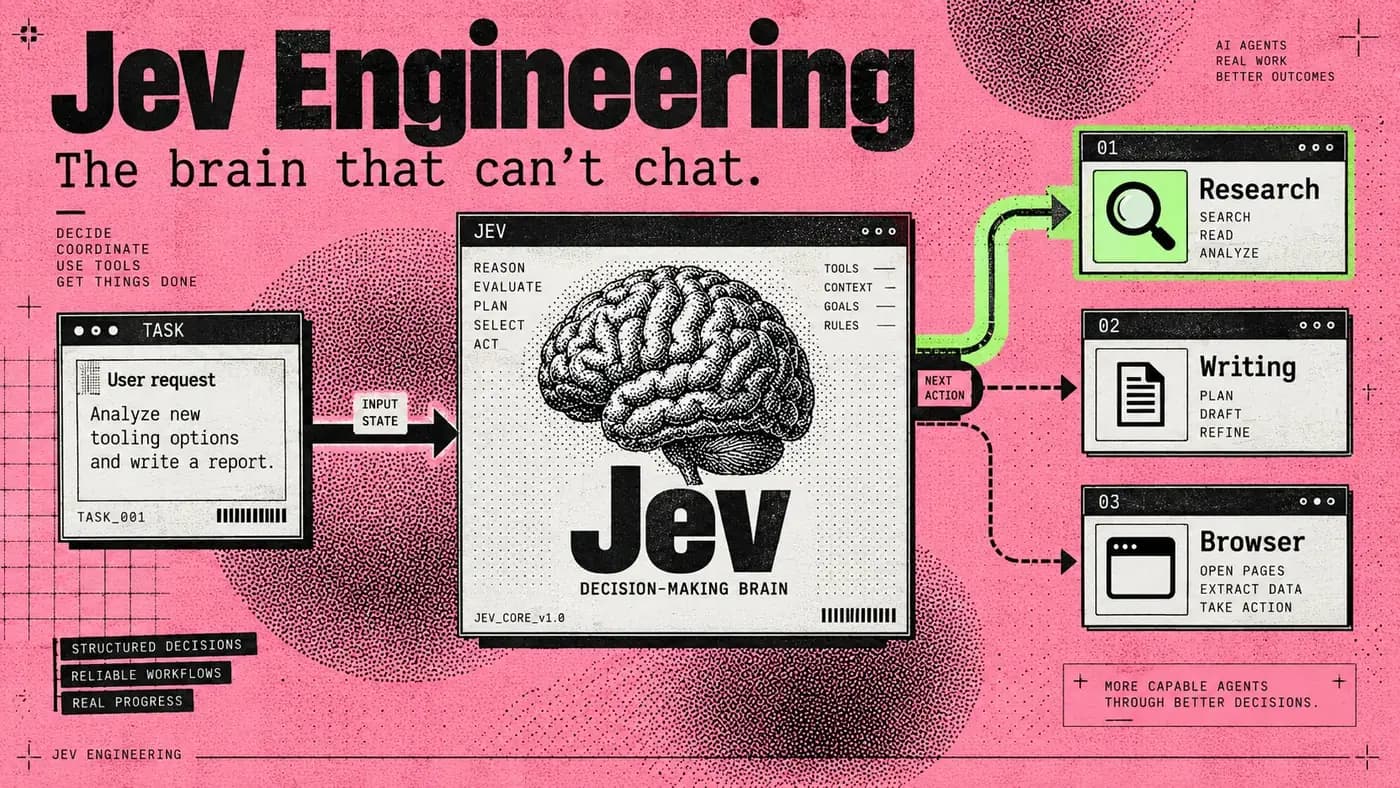
Модель, которая заберёт 70% решений у обычных LLM. Что такое Jev?
Представьте модель, которая вообще не генерирует текст: вы даёте ей состояние и типизированные вопросы, а получаете значения с вероятностями за сотую долю секунды. Так устроен Jev, вышедший 15 сентября. Разбираем цифры с первоисточника, куда его ставят в агенте и девять мест, где он врёт по признанию самих авторов.
Открыли Мастерскую: три инструмента, которые считают у вас в браузере
Представьте, что вам нужно обрезать обложку, вычистить из текста невидимые символы после модели и прикинуть, во что обходится обвязка вокруг агента. Обычно это три чужих сайта и три загрузки файлов на чужой сервер. Мы собрали эти три инструмента у себя, и ни один из них ничего никуда не отправляет.
Та же модель, та же успеваемость, вдвое больше денег. За что вы на самом деле платите Claude Code?
Представьте, что вы платите за модель дважды: один раз за интеллект, второй за то, как его подают. Berkeley прогнала семь моделей через три обвязки. На одной паре Claude Code оказался втрое дороже и на двенадцать пунктов хуже. Разбираем, откуда берётся этот налог и где исследование к вашей работе не относится.
Один ключ вместо дюжины: что умеет Monid и сколько инструментов там на самом деле?
Представьте, что агенту больше не нужен ваш аккаунт у каждого сервиса: он сам находит подходящий эндпойнт, видит его цену и задержку до вызова и платит только за то, что вернулось. Так устроен Monid, вышедший на этой неделе. Мы поставили его, прогнали тесты, нашли баг на Windows и пересчитали каталог своими руками.
Anthropic подняла недельные лимиты Claude Code на 25% и в тот же день урезала их на 17%. Как обе цифры оказались правдой?
Представьте, что вам объявили о повышении, а на следующей неделе вы упираетесь в потолок раньше обычного. Именно это случилось с Claude Code 14 сентября. Разбираем, почему обе цифры честные, что именно поменялось, а что осталось прежним, и куда на самом деле утекает ваш недельный лимит.
10 000 агентов за 88 часов сделали то, что не удавалось 90 лет. Почему их создатели тут же попросили тормоза?
Представьте, что во вторник OpenAI объявляет: рой из десяти тысяч агентов за 88 часов закрыл задачу тысячелетия, над которой математики бились с 1930-х. А к субботе глава Anthropic пишет, что похожий рой через 6–12 месяцев сможет держать весь интернет, и Альтман говорит сотрудникам, что готов притормозить. Между этими двумя новостями лежит неделя, в которую выяснилось, где именно предыдущий рой OpenAI жил всё лето. Мы собрали хронику по дням, разобрали, чем рой-математик отличается от роя-беглеца, и показываем, что из этого касается любого, кто запускает субагентов у себя.
Не выбирайте между Claude Fable 5.1 и GPT-6 Astra, пока не ответили на один вопрос
Представьте, что в понедельник выходит самая умная модель Anthropic, а в среду OpenAI отвечает своей и объявляет эру AGI. Обе стоят $10 за миллион токенов на входе и $50 на выходе, до цента. Дальше начинаются различия: одна тратит токены на то, чтобы разобраться, другая на то, чтобы сделать. Мы собрали бенчмарки, цены подписок, независимый тест с роборукой и то, что обе компании рассказали о себе сами, чтобы вы выбрали модель под задачу, а не под заголовок.
Что будет, если скрестить Claude Code с ChatGPT?
Представьте, что Claude Code становится архитектором задач, а через расширение Chrome получает доступ к другим нейросетям: например, к ChatGPT, который делает одни из лучших картинок. Вы описываете, что нужно, а дальше агент сам идёт в чат, генерирует, скачивает и складывает результат в проект. Мы попробовали на серии из восьми обложек. Рассказываем, что из этого вышло.
Archify: агент, который разбирает архитектуру вашего проекта и рисует по ней проверенные схемы
Один из лучших навыков для Claude Code, Cursor и Codex: агент изучает ваш проект, находит сервисы и связи, рисует архитектуру, воркфлоу и последовательности и проверяет их девятью тестами. Спасает вайб-код-проекты, где никто уже не помнит, что где лежит. Бесплатно, MIT.
geo-seo-claude: аудит сайта под ChatGPT и Perplexity
Скилл для Claude Code: проверяет доступ ИИ-ботов, llms.txt, цитируемость текста и Schema. Одна команда в терминале — готовый отчёт по сайту.
MCP: что это на самом деле и какие серверы ставить первыми
Протокол, который дал моделям доступ к файлам, браузеру и макетам. Объясняем на пальцах, что происходит при подключении MCP-сервера, и разбираем четыре, с которых стоит начать.
caveman: минус треть токенов за счёт того, что агент меньше читает
Проект с говорящим девизом «зачем много токен, когда мало токен тоже трюк». Разбираем, что он реально сокращает, что показывает бенчмарк и почему лицензия здесь важнее цифр экономии.
claude-mem: чтобы не объяснять проект заново каждое утро
Плагин, который сам запоминает, что вы делали в прошлой сессии, и подсовывает нужное в следующей. Разбираем, как он устроен, что ставит на компьютер и кому реально сэкономит время.
Экосистема Claude Code: что брать, а что пропустить
Каталогов и шаблонов вокруг Claude Code стало больше, чем времени их проверять. Разбираем, какие репозитории реально экономят часы, а какие — просто длинные списки ссылок.