Модель, которая заберёт 70% решений у обычных LLM. Что такое Jev?
Представьте модель, которая вообще не генерирует текст: вы даёте ей состояние и типизированные вопросы, а получаете значения с вероятностями за сотую долю секунды. Так устроен Jev, вышедший 15 сентября. Разбираем цифры с первоисточника, куда его ставят в агенте и девять мест, где он врёт по признанию самих авторов.
В этой статье5
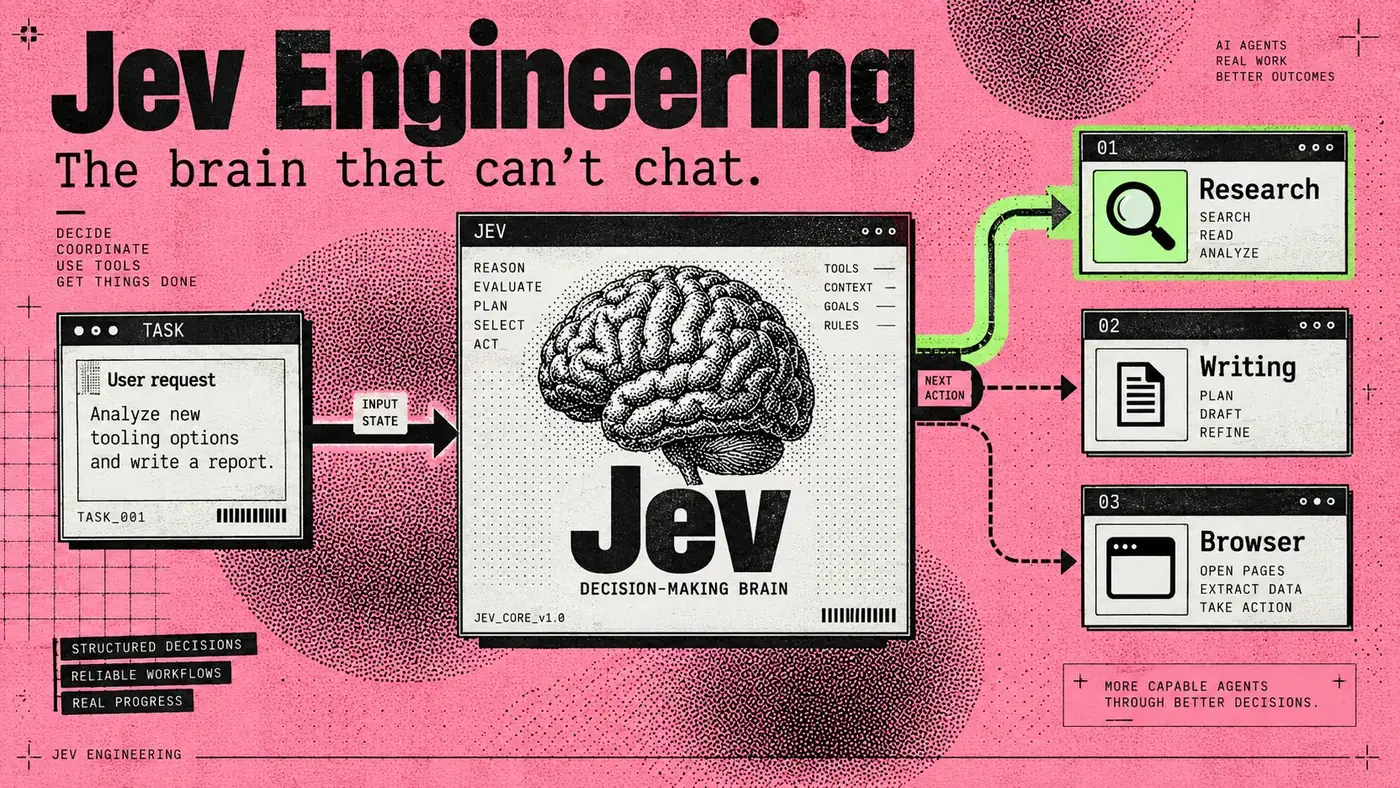
Jev это первая публичная System One модель от TypeSafe AI, запущенная 15 сентября 2026. Она не генерирует текст вообще: на вход идёт состояние и типизированные вопросы трёх видов (Choice, Score, Noul), на выходе значения с вероятностями и оценкой уверенности. Заявленные цифры с сайта компании: 0,114 секунды против 8,566 у фронтирной LLM и $0,000081 против $0,013880 за тот же рабочий процесс. Прайс jev-1.13.0 составляет $42 за миллиард входных токенов, выходные бесплатны. Vercel добавил модель в AI Gateway 16 сентября и через двое суток назвал её самым быстро принятым запуском в истории шлюза. Главное, чего нет в тредах: у авторов есть отдельная страница с девятью признанными режимами отказа, от неумения считать до чтения дат как текста, а доступ пока идёт через лист ожидания.
$42 за миллиард входных токенов. Не за миллион, за миллиард. Миллион стоит четыре с небольшим цента, и на этой цифре ломается привычка экономить вызовы модели. Сколько стоит сама обвязка вокруг этих вызовов, мы считали отдельно, сравнивая Claude Code, Codex и pi по деньгам.
Именно это обыгрывает название. Jev сокращение от Jevons: парадокс Джевонса гласит, что удешевление ресурса не сокращает, а увеличивает его потребление. Когда решение стоит сотые доли цента, его перестают беречь и начинают спрашивать модель там, где раньше писали регулярку и надеялись.
Модель, которая отказалась говорить
Несколько лет индустрия шла в одну сторону. RLHF учил модели угождать человеку, и результат мы видим каждый день: инструкции выполняются превосходно, а надёжности нет. Модель уверенно ошибается, теряет часть вариантов ответа и требует человека рядом.
TypeSafe пошла в обратную. Их алгоритм называется RLCD, обучение с подкреплением для калиброванных решений, и оптимизируется там не человеческое одобрение, а честность вероятности. Компанию основал Diogo Almeida, бывший исследователь OpenAI и соавтор работ по RLHF и InstructGPT, то есть человек, который строил ровно то, от чего теперь отталкивается.
Размен жёсткий: Jev не пишет текст. Совсем. Ни строки, ни списка, ни короткого резюме. Взамен он отвечает за десятки миллисекунд и не может выдумать значение, которого нет в схеме, потому что выбирает только из того, что вы перечислили.
Три вопроса, которые она понимает
Весь интерфейс это состояние плюс словарь вопросов. Вопросов ровно три вида. Choice выбирает один вариант из перечисленных, максимум 255. Score ставит оценку по описанным уровням. Noul возвращает вероятность того, что утверждение верно.
Важны не сами примитивы, а то, что все вопросы одного запроса считаются параллельно против одного состояния. В кукбуке у авторов есть замер: тринадцать вопросов по статье о GDPR, заданные одним вызовом вместо тринадцати, обходятся в 12,2 раза дешевле и отвечают в 10 раз быстрее, а ответы те же.
Первый вопрос, который здесь возникает: чем это отличается от structured output, который умеет любая современная LLM. Отличий два, и оба существенные. Обычная модель всё равно порождает ответ токен за токеном, и схема лишь проверяет то, что получилось, тогда как Jev сэмплирует все варианты разом и типовая ошибка исключена по построению. И второе: вместе с ответом приходит калиброванная уверенность, то есть число, которому можно доверить порог. Отсюда рабочий приём из документации: выше порога код действует сам, ниже отправляет случай человеку, и оба пути описаны заранее, а не угаданы по тону ответа.
curl -X POST https://api.typesafe.ai/v1/systemone \-H 'Authorization: Bearer $TYPESAFE_API_KEY' \-H 'Content-Type: application/json' \-d '{ "state": "...текст обращения...","model": "jev-latest","questions": { "is_urgent": { "type": "noul","instructions": "The message conveys urgency" } } }'# python: pip install typesafe-sdk (0.7.0 от 18 сентября)# js: npm i @typesafe-ai/sdk (0.6.0 от 15 сентября)
Куда это встаёт в агенте
Не вместо LLM, а между ней и кодом. Каждое место, где агент выбирает исполнителя, оценивает источник или решает, звать ли человека, это вопрос с конечным числом ответов, и платить за него генерацией текста больше не обязательно. Как разложить собственный цикл на генерацию и решения, где искать эти точки и что ставить на порог уверенности, мы разобрали по шагам в гайде про агентов на Claude Code и Jev.
| LLM | Jev | |
|---|---|---|
| Что отдаёт | Строку, которую надо разобрать | Типизированное значение с вероятностями |
| Сквозная задержка | 3–329 секунд | 70–500 мс |
| Цена прогона рабочего процесса | $0,013880 | $0,000081 |
| Уверенность | Надо выпрашивать в промпте | Приходит числом вместе с ответом |
| Умеет писать текст | Да, это его работа | Нет, и это осознанный отказ |
Экосистема подтянулась за сутки. Vercel добавил модель в AI Gateway 16 сентября под именем typesafe-ai/jev и вызывает её через experimental_evaluate в AI SDK, а через двое суток отчитался, что это самый быстро принятый запуск в истории шлюза: около 13 процентов платных команд за первые 24 часа. У LangChain появился TypeSafeClassifier. Для Claude Code есть официальный плагин, он ставится командой claude plugin marketplace add typesafe-ai/skills. Если вы ещё не разбирались, чем скилл отличается от плагина и когда нужен свой, у нас есть отдельный гайд про скиллы.
Где она ломается
Это лучшая часть документации и та, которой нет ни в одном треде. У TypeSafe есть отдельная страница про зазубрины jev-1.13, последняя ревизия от 17 сентября, и там девять признанных режимов отказа.
Модель читает буквально и отвечает на написанный вопрос, а не на задуманный. Она не калькулятор: не считает элементы списка, а узнаёт форму ответа, и ошибка растёт вместе со списком. Даты она видит как текст, поэтому сравнивать их нельзя, только извлекать по частям и складывать в коде. Точность падает, когда в состояние навалено лишнее, и это ровно та дисциплина, которой мы учим на курсе про память Claude Code: в окно кладут нужное, а не всё подряд. И структурных гарантий нет: в примере самих авторов вопрос и его отрицание, заданные двумя Noul, дают 0,72 и 0,47, в сумме 1,19.
Отдельно про нас. Основной язык обучения английский, остальные заявлены как поддержанные, но слабее. Для русских и ивритских текстов это значит обязательный замер на своём контенте, а не перенос чужих порогов уверенности.
Про треды, из которых эту новость узнали многие
Инструкция «поставь за 7 минут», собравшая 188 тысяч просмотров, предлагает сохранить TYPESAFE_API_KEY через чат с ботом. Так делать не нужно: ключ живёт в переменной окружения, а не в переписке, которую вы не контролируете. Второй тред, про семь SEO-сценариев, содержательнее и ближе к делу, но и там цена решения названа без методики замера.
Что мы проверили сами
Мы собирались прогнать модель руками, как делаем с каждым инструментом. Не вышло: доступ идёт через лист ожидания, и кнопка на главной так и называется. Поэтому все цифры здесь взяты у первоисточника, и это честнее, чем пересказывать чужие.
Заодно выяснилось, зачем вообще ходить к первоисточнику. За цифрами мы сначала сунулись в Forbes, тот отдал 403 на обычный запрос, а в его заголовке стоит «100x». У TypeSafe на главной цифры другие: 193,6 раза по скорости и 444,6 по цене. Разница не в пользу пересказа.
Ещё одно наблюдение из npm и PyPI: клиенты разъехались. Python-пакет typesafe-sdk дошёл до 0.7.0 восемнадцатого сентября, а JavaScript-пакет @typesafe-ai/sdk стоит на 0.6.0 с пятнадцатого. Проекту неделя, и это нормально, но если вы строите на JS, проверьте паритет возможностей до того, как закладываться.
Сразу про цифру в заголовке: 70 процентов это наша оценка доли вызовов, которые на деле сводятся к выбору, оценке или ответу «да или нет», а не замер и не данные TypeSafe. Считайте это ставкой, которую мы готовы защищать.
Наше мнение, с которым можно спорить: место для Jev сейчас ровно одно, и оно узкое. Это развилка с конечным числом вариантов, за которую вы сегодня платите генерацией текста: выбор исполнителя, отбор источников, гейт перед необратимым действием. Переносить туда счёт, даты и разбор длинного документа целиком не нужно, это буквально список из страницы про зазубрины. А если ваш контент русский или ивритский, между «интересно» и «внедряем» обязан стоять замер на своей выборке: пороги уверенности из чужого английского примера вам не подойдут. Как выглядит такой замер для страниц сайта, показано в разборе аудита на попадание в ответы ИИ, а весь путь от разовой проверки до процесса мы ведём в курсе по SEO-автоматизации.
Версии и цены меняются
Всё в этой статье зафиксировано на 20 сентября 2026: jev-1.13.0, прайс $42 за миллиард входных токенов, лимиты 250 000 токенов в секунду и 1200 запросов в минуту. В документации отдельно сказано, что лимиты двигают без предупреждения. Проверяйте актуальные значения перед расчётами.
Источники8развернуть
- TypeSafe AI, главная и блог «Introducing System One Models & Jev», 15 сентября 2026 — https://typesafe.ai
- Документация: модели и прайс — https://docs.typesafe.ai/models
- Документация: зазубрины jev-1.13, ревизия 17 сентября 2026 — https://docs.typesafe.ai/model-jaggedness/jev-1.13
- Документация: кукбук о параллельных вопросах — https://docs.typesafe.ai/cookbooks/parallel_questions
- Vercel, «TypeSafe AI's Jev now available on AI Gateway», 16 сентября 2026 — https://vercel.com/changelog/typesafe-ai-jev-now-available-on-ai-gateway
- Тред @akshay_pachaar «LLM vs Jev», источник анимации в тексте, 19 сентября 2026 — https://x.com/akshay_pachaar/status/2101309986156712025
- Тред @irabukht о семи SEO/GEO-сценариях, 19 сентября 2026 — https://x.com/irabukht/status/2101375295152652372
- Тред @0xCodila об установке за 7 минут, 20 сентября 2026 — https://x.com/0xCodila/status/2101433560796467348
Комментарии