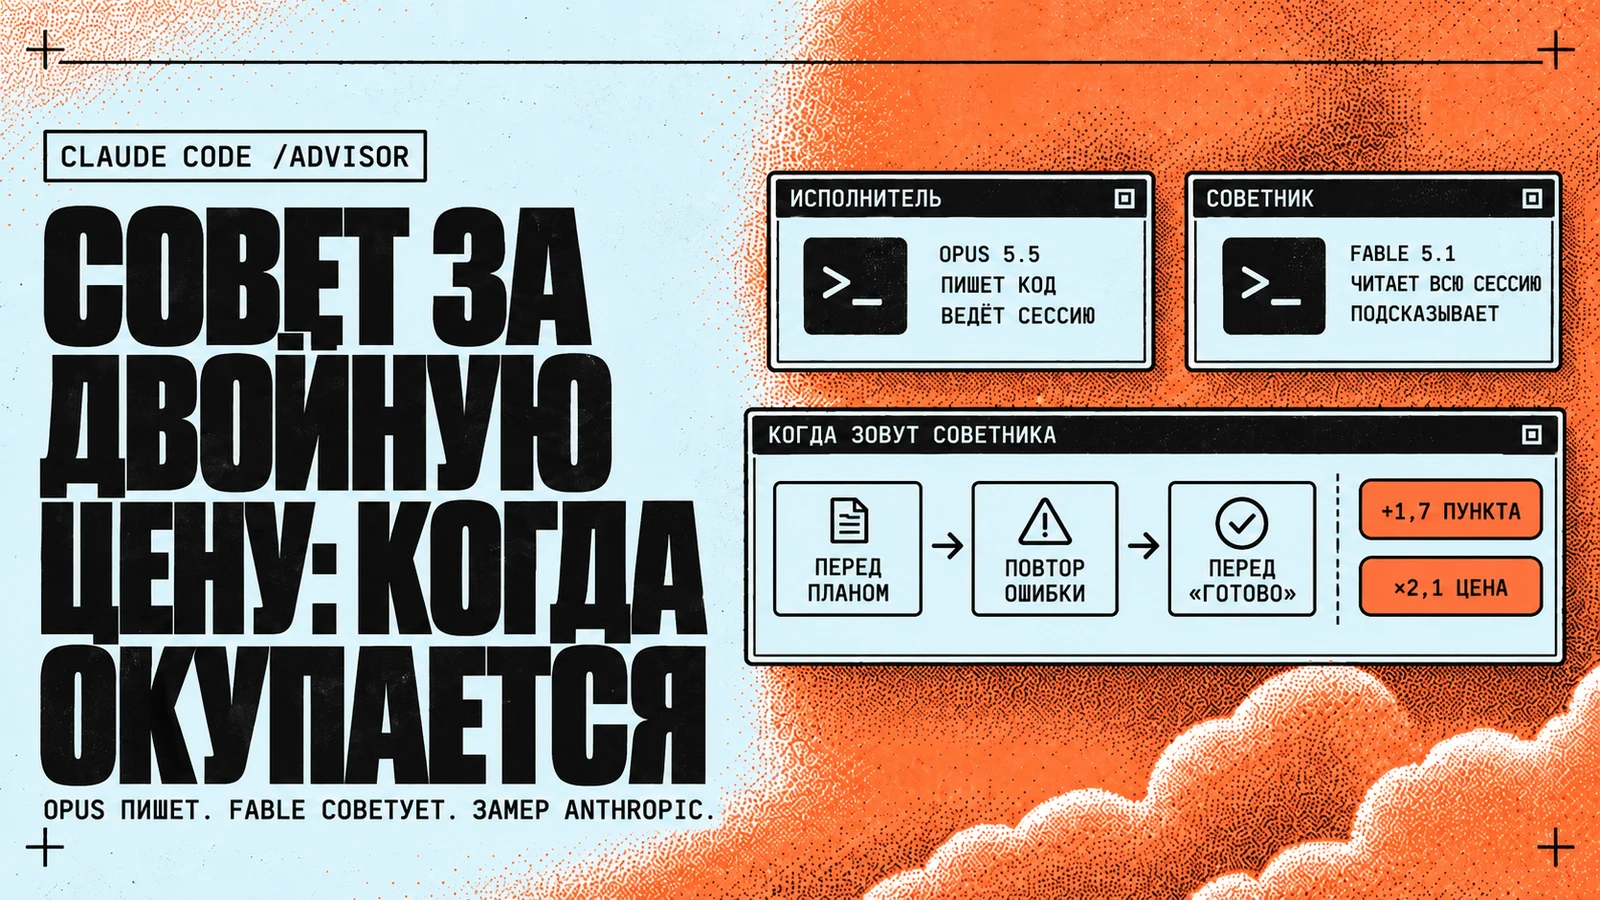
Fable 5.1 в роли советника добавляет Opus 5.5 всего 1,7 пункта за двойную цену. Когда /advisor всё-таки окупается?
Представьте: Opus 5.5 пишет код, а Fable 5.1 подсказывает в трудных местах. Замер Anthropic дал паре +1,7 пункта за 2,1× цены. Разбираем, где это окупается.
В цифрах
В этой статье6
/advisor в Claude Code подключает к основной модели второго, более сильного советника. Советник читает весь разговор, включая вызовы инструментов, и возвращает подсказку; когда его звать, решает сама модель. Функция экспериментальная и работает только через Anthropic API. Для пары Opus 5.5 + Fable 5.1 у Anthropic есть свой замер: 90,1% на внутреннем бенчмарке агентного кода при $2,92 за попытку. Это +1,7 пункта к Opus 5.5 на high, на грани шума, примерно за 2,1 раза дороже. Opus 5.5 на xhigh без советника набрал 91,1%. Советник окупается, когда основная модель заметно слабее советника и сама зовёт его в трудных местах; если она близка к нему по силе, дешевле поднять ей effort.
+1,7 пункта за 2,1 раза дороже. Столько, по замеру самой Anthropic, даёт пара, о которой сейчас спрашивают чаще всего: Opus 5.5 пишет код, Fable 5.1 советует. В X эту связку продают как способ «сэкономить тысячи». В документации Anthropic таких цифр нет, а для этой пары замер показывает обратное.
Сама идея при этом хорошая, и есть пары, где она работает. Ниже о том, как устроен /advisor, что именно намерила Anthropic и как понять, окупится ли советник на вашей задаче.
Что делает /advisor в Claude Code
Основная модель (Anthropic называет её исполнителем) работает как обычно, но в ключевые моменты может спросить совета у второй модели. Советник получает весь разговор целиком: каждый вызов инструмента, каждый результат. Он возвращает подсказку, и исполнитель её применяет. Если файл или результат команды противоречат совету, Claude показывает конфликт и не выполняет совет вслепую.
Советник работает на стороне Anthropic как серверный инструмент и доступен и на подписке, и на API. Модель советника выбираете вы, а момент вызова выбирает Claude. По документации, чаще всего он советуется в трёх местах:
- 1
Перед выбором подхода
Когда план ещё не начали выполнять и ошибка в нём стоит дороже всего.
- 2
Когда ошибка повторяется
Исполнитель упёрся в одно и то же, и свежий взгляд нужнее ещё одной попытки.
- 3
Перед словом «готово»
Проверка перед тем, как объявить задачу выполненной.
Момент всё равно выбирает модель. Настройки «звать всегда» или «звать не чаще» нет, повлиять можно только словами в промпте, например consult the advisor before you continue.
Идея не новая. Anthropic описала стратегию советника в блоге 9 апреля 2026, в Claude Code экспериментальный Advisor Tool появился в версии 2.1.117 (22 апреля). Заговорили о нём снова из-за Opus 5.5: 22 сентября он стал моделью Opus по умолчанию в Claude Code, и вопрос «а не дать ли ему в советники Fable 5.1» возник сам собой.
Как включить и что вы увидите
/advisor # выбрать модель из списка/advisor fable # сразу Fable/advisor off # выключитьclaude --advisor opus # только на эту сессию
Выбор сохраняется в пользовательских настройках как advisorModel. После старта сессии появляется уведомление о том, что Advisor Tool включён и может тратить больше токенов. Когда исполнитель зовёт советника, в транскрипте видна строка Advising с именем модели, а текст совета открывается по Ctrl+O. Субагенты наследуют советника.
Главное ограничение: советник не может быть слабее исполнителя. Для Opus 5 и Opus 5.5 допустимы только Fable и Opus 5+. Если пара не проходит, Claude Code советника не подключает и предупреждает об этом.
| Основная модель | Кого можно взять советником |
|---|---|
| Haiku 4.5 | Fable, Opus, Sonnet |
| Sonnet 5.5 | Fable, Opus 5+, Sonnet 5.5 |
| Opus 5 / Opus 5.5 | Fable, Opus 5+ |
| Fable 5.1 | только Fable 5.1 |
С Fable есть нюанс. На части тарифов Fable списывается из usage credits, а не из лимитов подписки. Если аккаунту нужно одноразовое согласие, /advisor fable не сохранит выбор и отправит в /model fable: там соглашаетесь, возвращаете основную модель и снова выбираете Fable советником.
Что намерила Anthropic для пары Opus 5.5 + Fable 5.1
В руководстве по выбору между ценой и качеством Anthropic приводит прогон на внутреннем бенчмарке агентного кода. Это обычный API-агент, не Claude Code, по пять попыток на задачу.
Opus 5.5 на high с советником Fable 5.1: +1,7 пункта к Opus 5.5 одному на high примерно за 2,1 раза дороже
Anthropic сама пишет, что разница в 1,7 пункта «на грани шума» между прогонами. По сравнению с Opus 5.5 на medium, его уровнем по умолчанию, выходит +3,5 пункта примерно за 3,5 раза дороже.
Самое полезное наблюдение там же: результат пары ложится примерно на собственную кривую effort у Opus 5.5. Opus 5.5 один на xhigh набрал 91,1% за $4,11 за попытку. Получается, что советник покупает примерно то же, что и разрешение модели дольше думать.
Ещё две детали объясняют, куда уходят деньги. Opus 5.5 звал советника в среднем 1,4 раза за попытку, и в 4% попыток не позвал вовсе. Токены исполнителя при этом почти не изменились ($1,36 против $1,38 без советника), а сами консультации стоили $1,55. Экономии на исполнителе нет, советник идёт сверху.
Где советник сделал хуже
На чтении графиков Opus 5.5 на low с советником Fable 5.1 позвал его в 1 задаче из 300 и набрал на 7 пунктов меньше, чем Opus 5.5 один, при примерно той же цене. Советник помогает, только если его зовут.
Откуда тогда истории про экономию
Из ранних замеров на других парах. В апрельском блоге Anthropic показывала Sonnet с советником Opus на SWE-bench Multilingual: +2,7 пункта к Sonnet одному и на 11,9% дешевле за задачу. Haiku с советником Opus на BrowseComp набрал 41,2% против 19,7% у Haiku одного.
Общее у этих пар одно: исполнитель заметно слабее советника. Anthropic формулирует это прямо: советник может передать только те способности, которых у исполнителя нет. Когда исполнитель уже близок к советнику, платить приходится, а передавать почти нечего. Для справки: на подмножестве SWE-bench Pro Opus 5.5 по умолчанию сравнялся с Fable 5.1 по умолчанию примерно за пятую часть цены решённой задачи. Разрыв между ними небольшой, и замер выше это подтверждает. Как Fable 5.1 выглядит против конкурентов, мы разбирали отдельно.
Почему советник не дешёвый
У советника нет кэша. Каждый вызов заново читает весь транскрипт по тарифу советника, без переиспользования между вызовами. Цены на 5 октября 2026 за миллион токенов вход/выход: Opus 5.5 $4/$20, Fable 5.1 $10/$50. В длинной сессии, где транскрипт растёт, каждый следующий совет дороже предыдущего.
На подписке расход идёт в лимиты плана, а Fable-советник на части тарифов идёт в usage credits. Расход советника виден в /usage. Если вы и так упираетесь в недельный лимит, советник его приблизит; как длина контекста съедает лимит, мы считали на сентябрьских цифрах.
Когда /advisor окупается
- 1
Исполнитель заметно слабее советника
Sonnet или Haiku с советником Opus или Fable. Документация предлагает именно такие пары: рутина на быстрой модели, решения у сильной.
- 2
Задача длинная и многошаговая
Большой рефакторинг, отладка с повторяющейся ошибкой, проверка перед сдачей. На коротких задачах пользы мало.
- 3
Исполнитель правда зовёт советника
Посмотрите, как часто в транскрипте появляется Advising. Если почти никогда, вы получаете обычный прогон; если на каждой задаче, дешевле сразу работать на модели советника.
- 4
Для Opus 5.5 сравните с effort
Прежде чем звать Fable, поднимите Opus 5.5 effort до xhigh на тех же задачах. По замеру Anthropic это даёт примерно тот же результат.
Наше мнение, с которым можно спорить: для Opus 5.5 советник Fable 5.1 не стоит держать включённым всегда. Он имеет смысл как точечный приём на одной трудной задаче, где Opus уже дважды ошибся. Мы окажемся неправы, если на ваших задачах разрыв между Opus 5.5 и Fable 5.1 больше, чем на бенчмарке Anthropic. Это проверяется за вечер: 10–20 типичных задач, два прогона, сравнение счёта в /usage.
Ограничения
Функция экспериментальная, поведение и цены могут поменяться. Работает только через Anthropic API: на Amazon Bedrock, Google Cloud и Microsoft Foundry советника нет. Отключается целиком переменной CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1.
Советник хорошо работает в паре «быстрая модель + сильная». Двум сильным моделям он даёт примерно то же, что и лишнее время на размышления, только дороже. Если интересно, как вообще считать цену задачи, а не токена, посмотрите наш разбор GPT-6 Sol против Opus 5.5.
Версии и цены на 5 октября 2026: Claude Code с экспериментальным Advisor Tool, Opus 5.5, Fable 5.1. Версии и цены меняются, проверяйте актуальные.
Источники6развернуть
- Anthropic, «Escalate hard decisions with the advisor tool», документация Claude Code, проверено 5 октября 2026 — https://code.claude.com/docs/en/advisor
- Anthropic, «Model configuration: Fable and usage credits», документация Claude Code, проверено 5 октября 2026 — https://code.claude.com/docs/en/model-config#fable-and-usage-credits
- Anthropic, «Claude Code changelog», проверено 5 октября 2026 — https://code.claude.com/docs/en/changelog
- Anthropic, «Advisor tool», документация Claude API, проверено 5 октября 2026 — https://platform.claude.com/docs/en/agents-and-tools/tool-use/advisor-tool
- Anthropic, «Optimizing for cost and intelligence: Advisor strategy», документация Claude API, проверено 5 октября 2026 — https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence#advisor-strategy-escalate-hard-decisions
- Anthropic, «The advisor strategy», блог Claude, 9 апреля 2026 — https://claude.com/blog/the-advisor-strategy
Читать дальше
 GPT-6 Sol вдвое дешевле Opus 5.5 за токен. Почему за задачу разница всего 20%?26 сентября 2026
 Не выбирайте между Claude Fable 5.1 и GPT-6 Astra, пока не ответили на один вопрос7 сентября 2026
 Anthropic подняла недельные лимиты Claude Code на 25% и в тот же день урезала их на 17%. Как обе цифры оказались правдой?15 сентября 2026

Комментарии