Статьи
Разборы инструментов, репозиториев и подходов — с датой проверки на каждом материале
40материалов
Меньше кода, а тестов больше: Ponytail учит Claude Code не писать лишнего
Собрать проект с Claude Code без лишних сотен строк: ставим Ponytail, разбираем его лестницу вопросов, ревью перед публикацией и цифры из бенчмарка автора.
РазборClaude Code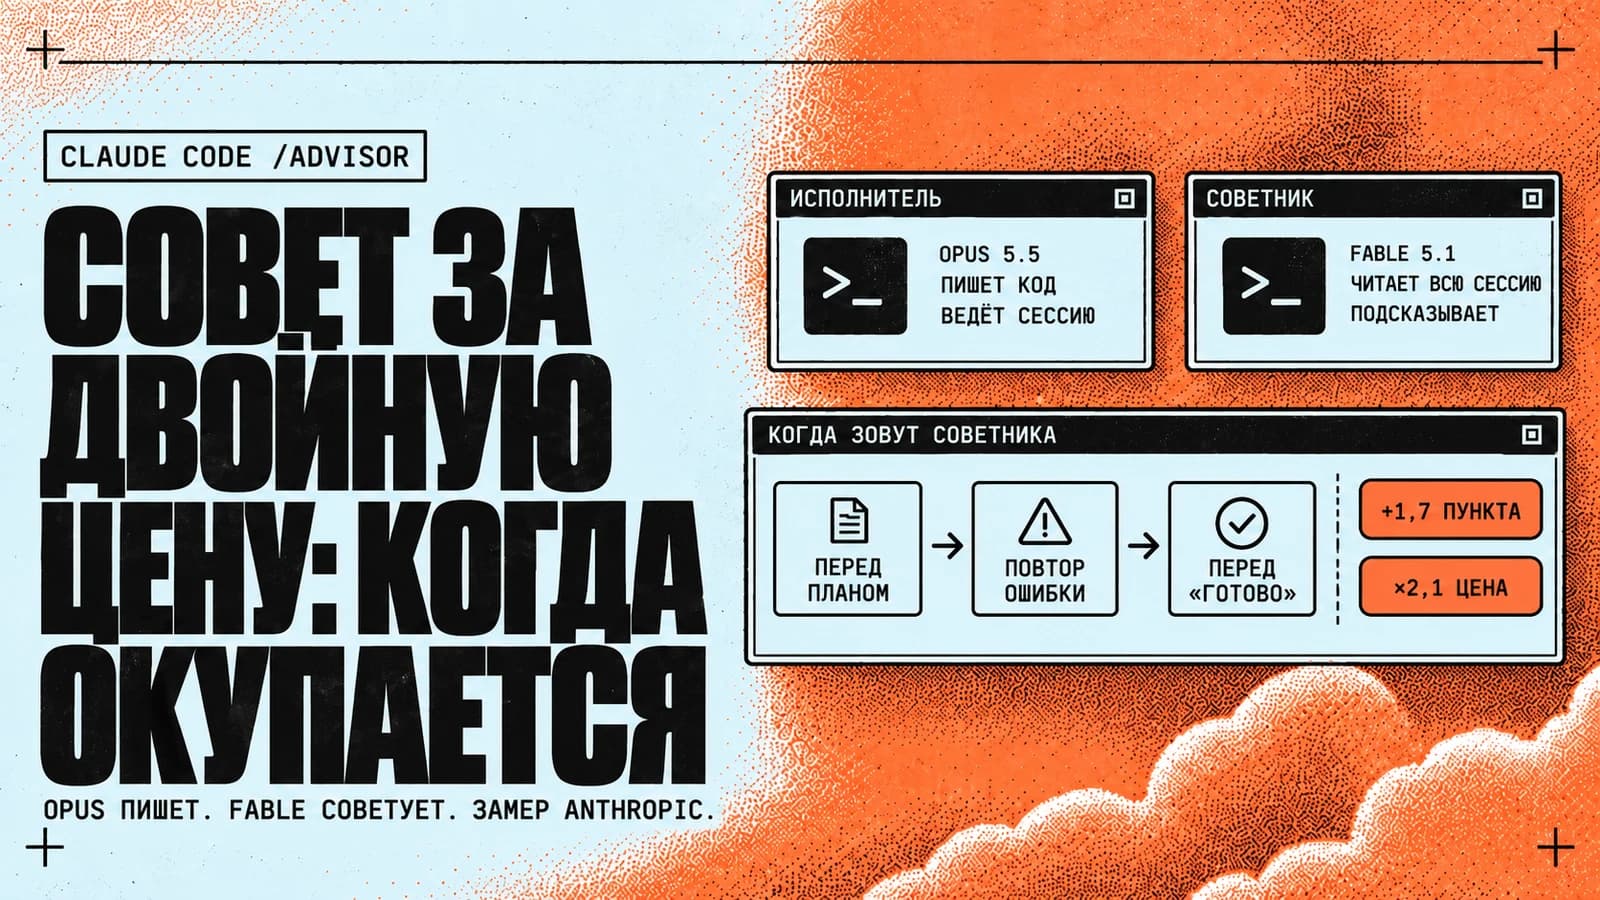
Fable 5.1 в роли советника добавляет Opus 5.5 всего 1,7 пункта за двойную цену. Когда /advisor всё-таки окупается?
Представьте: Opus 5.5 пишет код, а Fable 5.1 подсказывает в трудных местах. Замер Anthropic дал паре +1,7 пункта за 2,1× цены. Разбираем, где это окупается.
РазборClaude Code
57 токенов в секунду вместо 30 на том же Mac. За счёт чего Magnitude обгоняет llama.cpp?
Можно ли гонять агента на локальной модели вдвое быстрее, не меняя железо? Разбираем Magnitude: как он настраивает ядра под чип и где llama.cpp пока быстрее.
РазборAI-агенты
Скилл, из которого у Cloudflare выросли 7 245 найденных багов. Что он найдёт в вашем репозитории?
Можно ли доверить аудит безопасности Claude Code? Cloudflare выложила скилл, где находку проверяет другой агент. Разбираем фазы, запуск и чего в нём нет.
РазборClaude Code
Hindsight сам пишет вики о вашем репозитории. Нужна ли Claude Code такая память?
Научить Claude Code и Codex помнить, почему в проекте так решили: разбираем Hindsight, откуда его 94,6% и какие умолчания сменить до первой сессии.
РазборClaude Code
GPT-6 Sol вдвое дешевле Opus 5.5 за токен. Почему за задачу разница всего 20%?
На прайсе GPT-6 Sol ровно вдвое дешевле Claude Opus 5.5, а на задаче в независимом тесте лишь на 21% и слабее на 3 балла. Считаем, где исчезает «вдвое».
РазборAI-агенты
Агентам выдали начальника, задачи и бюджет. Нужен ли он тем, кто уже работает в Claude Code?
Свести пять окон Claude Code и Codex в одну очередь задач с ролями и бюджетами: это делает Paperclip. Разбираем, где он помогает и где лимит опаздывает.
РазборAI-агенты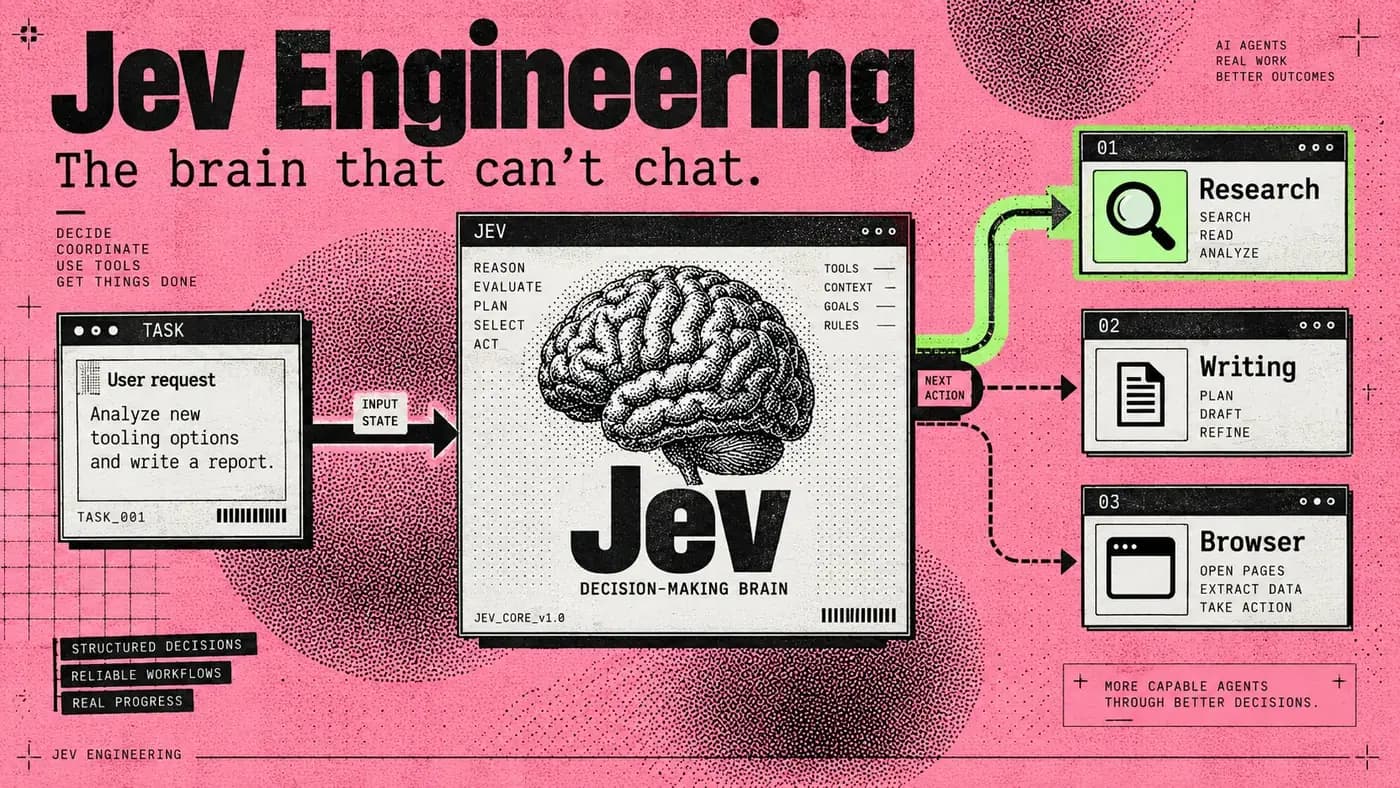
Модель, которая заберёт 70% решений у обычных LLM. Что такое Jev?
Представьте модель, которая вообще не генерирует текст: вы даёте ей состояние и типизированные вопросы, а получаете значения с вероятностями за сотую долю секунды. Так устроен Jev, вышедший 15 сентября. Разбираем цифры с первоисточника, куда его ставят в агенте и девять мест, где он врёт по признанию самих авторов.
РазборAI-агенты
Та же модель, та же успеваемость, вдвое больше денег. За что вы на самом деле платите Claude Code?
Представьте, что вы платите за модель дважды: один раз за интеллект, второй за то, как его подают. Berkeley прогнала семь моделей через три обвязки. На одной паре Claude Code оказался втрое дороже и на двенадцать пунктов хуже. Разбираем, откуда берётся этот налог и где исследование к вашей работе не относится.
РазборAI-агенты
Один ключ вместо дюжины: что умеет Monid и сколько инструментов там на самом деле?
Представьте, что агенту больше не нужен ваш аккаунт у каждого сервиса: он сам находит подходящий эндпойнт, видит его цену и задержку до вызова и платит только за то, что вернулось. Так устроен Monid, вышедший на этой неделе. Мы поставили его, прогнали тесты, нашли баг на Windows и пересчитали каталог своими руками.
РазборAI-агенты
Не выбирайте между Claude Fable 5.1 и GPT-6 Astra, пока не ответили на один вопрос
Представьте, что в понедельник выходит самая умная модель Anthropic, а в среду OpenAI отвечает своей и объявляет эру AGI. Обе стоят $10 за миллион токенов на входе и $50 на выходе, до цента. Дальше начинаются различия: одна тратит токены на то, чтобы разобраться, другая на то, чтобы сделать. Мы собрали бенчмарки, цены подписок, независимый тест с роборукой и то, что обе компании рассказали о себе сами, чтобы вы выбрали модель под задачу, а не под заголовок.
РазборClaude Code
caveman: минус треть токенов за счёт того, что агент меньше читает
Проект с говорящим девизом «зачем много токен, когда мало токен тоже трюк». Разбираем, что он реально сокращает, что показывает бенчмарк и почему лицензия здесь важнее цифр экономии.
РазборClaude Code